Opus 5.5 w skrócie
Anthropic potwierdziło premierę 22 września 2026. Claude Opus 5.5 otwiera rodzinę Claude 5.5. Firma stawia na pracę agentową i niższy koszt wykonywania zadań w porównaniu z Opusem 5.
- Porównanie z Astrą: wybór zależy od zadania. W dwóch omawianych dalej benchmarkach lider jest inny.
- Koszt: rozdziel cenę tokenów, koszt całej sesji i miesięczny abonament. To trzy różne miary.
- Decyzja o zmianie: przygotuj kilka własnych zadań z kryteriami odbioru. Sprawdź wynik, poprawki i rachunek, zanim przeniesiesz cały proces.
Ten artykuł rozwija naszą rolkę o premierze. Oficjalne liczby zestawiamy z pytaniami, które pomogą ocenić model w codziennej pracy. Nie przedstawiamy przykładów producenta jako własnych doświadczeń.
Model, aplikacja i agent: co właściwie porównujemy?
Nazwa modelu nie opisuje całego środowiska pracy. Ten sam model może odpowiadać w czacie, pomagać przy kodzie albo działać jako część systemu połączonego z firmowymi narzędziami. Efekt zależy również od materiałów wejściowych, udzielonych uprawnień, sposobu uruchamiania narzędzi i sprawdzania rezultatów.
Przy zakupie dostępu warto więc zapisać pełną konfigurację. Czy potrzebujesz rozmowy w aplikacji, integracji przez API, pracy na repozytorium, czy dostępu do konkretnych dokumentów? Czy narzędzie potrafi jedynie przygotować zmianę, czy również ją opublikować? Odpowiedź „korzysta z Opusa” nie rozstrzyga tych pytań.
To także powód, dla którego porównanie dwóch efektownych nagrań bywa mylące. Jeden autor może dostarczyć kompletną dokumentację i gotowe testy, a drugi pojedyncze zdanie. Wtedy oceniamy jednocześnie model, przygotowanie zadania i środowisko, zamiast izolować jedną różnicę.
Claude Opus 5.5 kontra GPT-6 Astra: dwa różne wyniki
W tabeli Anthropic znajdziemy:
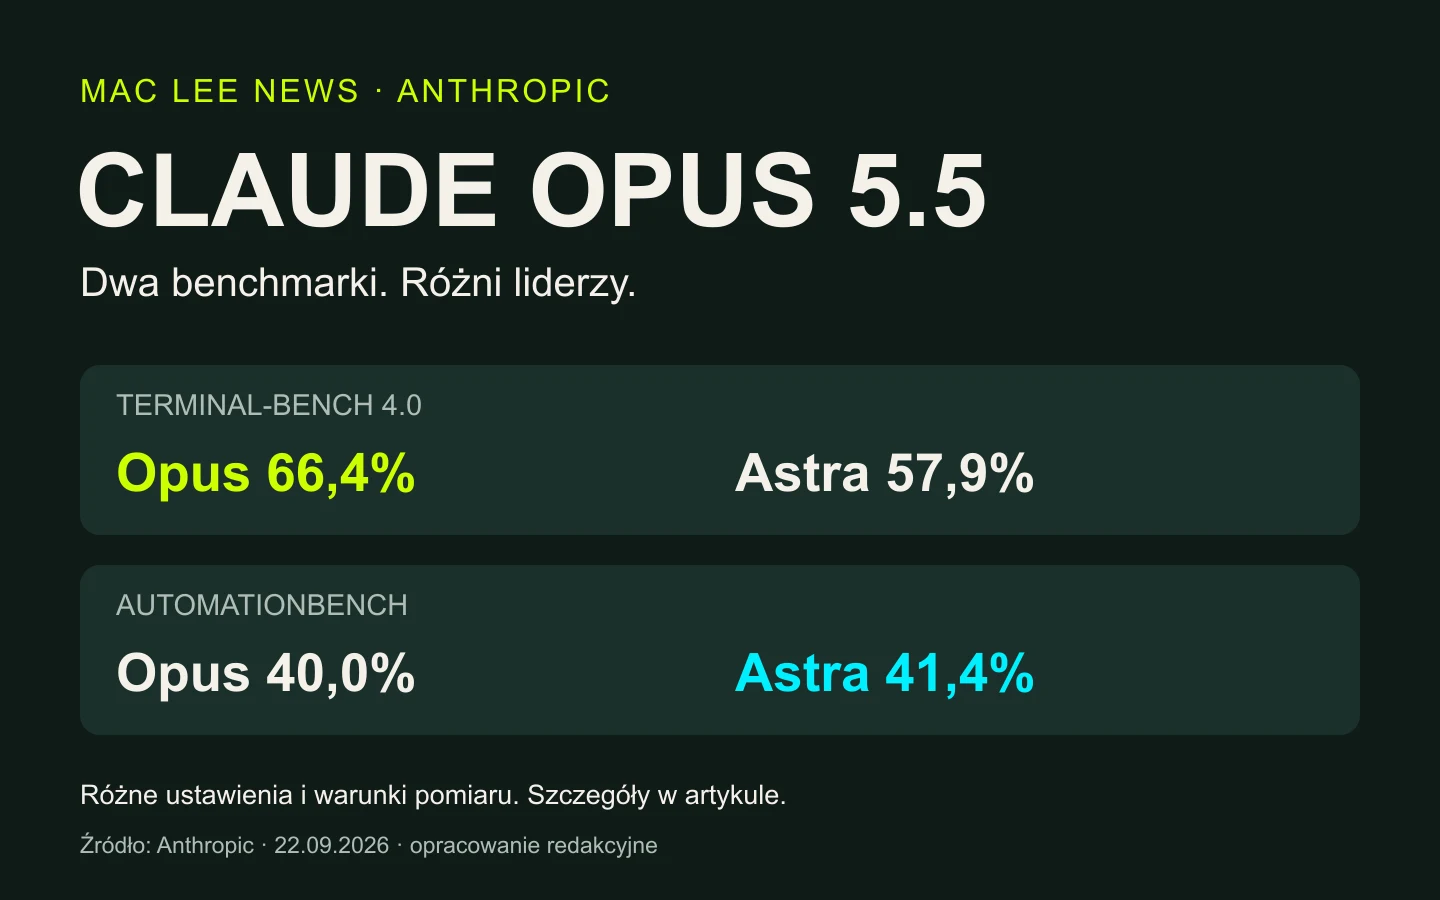
- Terminal-Bench 4.0: Opus 5.5 — 66,4%; GPT-6 Astra — 57,9%.
- AutomationBench: Opus 5.5 — 40,0%; GPT-6 Astra — 41,4%.
Terminal-Bench dotyczy zadań w terminalu. Opus używał ustawienia xhigh, Astra high; wynik Astry pochodzi z raportowania OpenAI. Błąd standardowy dla Opusa wynosi ±2,6 punktu procentowego. AutomationBench mierzy procesy biznesowe; Zapier ocenił Opusa we wczesnym dostępie, a wynik Astry pochodzi z publicznego rankingu.
Nasz wniosek: żadna z tych tabel nie uzasadnia hasła „lepszy we wszystkim”. Różnica 8,5 punktu procentowego w pierwszym zestawieniu nie oznacza, że programista wykona pracę o 8,5% szybciej. Odsetek zaliczonych zadań i czas pracy człowieka mierzą inne rzeczy. W drugim zestawieniu 1,4 punktu przewagi również nie wystarcza, by bez pełnej analizy niepewności ogłosić rozstrzygającą wygraną.
Gdy oglądasz kolejny ranking, sprawdź wersję benchmarku, ustawienia modelu, dostępne narzędzia i autora pomiaru. Nie przenoś wyników ze starszej edycji do nowej tabeli tylko dlatego, że obie mają podobną nazwę. Zachowaj też rozróżnienie między najwyższym wynikiem przy drogim ustawieniu a efektem, którego oczekujesz w zwykłej sesji.
Ile kosztuje Opus 5.5? Tokeny i koszt zadania
Oficjalne wyjaśnienie kosztów podaje ceny API za milion tokenów: 4 USD za wejście, 20 USD za wyjście i 0,20 USD za odczyt z pamięci podręcznej. Zapis do cache jest osobną pozycją. Podane stawki nie są miesięcznym abonamentem Claude.
Tokeny są jednostkami rozliczania treści przetwarzanej przez model. Polecenie i materiały wejściowe zwiększają wejście, a wygenerowana odpowiedź zwiększa wyjście. Długa praca agenta może obejmować wiele kolejnych wywołań, dlatego cena pojedynczej wiadomości nie wystarcza do oszacowania całego procesu.
Przykład obliczeniowy redakcji: przy 100 tysiącach nowych tokenów wejściowych i 10 tysiącach wyjściowych otrzymujemy 0,40 USD + 0,20 USD = 0,60 USD. To uproszczony rachunek za wskazane tokeny, bez cache, dodatkowych narzędzi i pozostałych opłat. Nie jest ofertą cenową wykonania strony czy raportu.
Do porównania modeli dopisz liczbę ponowień i czas ręcznych poprawek. Sesja, która wygląda tanio, ale kończy się błędnym eksportem lub zmianą wymagającą odkręcenia, nie daje automatycznie niższego kosztu zaakceptowanego rezultatu. Zapisz zarówno rachunek API, jak i to, co udało się dostarczyć.
Co oznacza deklaracja „40% taniej”?
Anthropic deklaruje około 40% niższy koszt typowej pracy przy domyślnych ustawieniach względem Opusa 5. Ceny tokenów wejściowych i wyjściowych obniżono o 20%. Pozostała różnica zależy od sposobu wykonania zadania. To deklaracja producenta, nie gwarancja oszczędności w każdym projekcie. Źródło: ogłoszenie premiery.
Nie należy przeliczać tego na obniżkę rachunku za Pro lub Max. Użytkownik abonamentu rozlicza dostęp według zasad swojego planu, podczas gdy integracja API ma rachunek zależny od użycia. Przed zmianą planu sprawdź bieżące warunki konta i to, czy problemem jest limit, dostęp do narzędzi, czy jakość wyników.
Dla firmy sensowną jednostką porównania może być „koszt poprawnie przygotowanego raportu” albo „koszt zmiany, która przeszła przegląd i testy”. Licząc oszczędności, utrzymaj tę samą definicję sukcesu. Tańszy raport bez sprawdzonych źródeł nie jest równoważny raportowi gotowemu do wysłania klientowi.
Programowanie: czego wymagać poza działającym demo?
Poniższe przykłady to nasza propozycja oceny, nie rezultaty przeprowadzonego testu. Przy stronie internetowej dobrym zadaniem porównawczym byłaby naprawa konkretnej usterki na telefonie. Daj obu modelom ten sam kod, opis błędu i listę ekranów, które mają pozostać bez zmian. Poproś o wskazanie przyczyny przed przygotowaniem poprawki.
Po wykonaniu zadania sprawdź nie tylko wskazany widok. Otwórz menu, formularz i podstrony korzystające ze wspólnego komponentu. Porównaj zakres zmian: czy model usunął przyczynę, czy przebudował pół projektu? W pracy komercyjnej niepotrzebna przebudowa oznacza dodatkową weryfikację nawet wtedy, gdy pierwsze wrażenie jest dobre.
Przy większym zadaniu ustal, co ma być dowodem zakończenia. Może nim być przechodzący test, poprawny eksport albo zestaw sprawdzonych scenariuszy. Deklaracja agenta „gotowe” powinna prowadzić do konkretnego pliku i wyniku kontroli. Zachowaj wersję sprzed zmian, aby móc porównać zachowanie i bezpiecznie wrócić do punktu wyjścia.
Dokumenty i analiza: oceniaj zgodność ze źródłem
Do porównania pracy z dokumentami przygotowalibyśmy krótki zestaw danych z jedną celowo brakującą informacją. Zadanie: raport dla osoby decyzyjnej i kilka slajdów. Kryterium odbioru powinno obejmować oznaczenie braków, zgodność liczb, oddzielenie obserwacji od rekomendacji i czytelność eksportu.
Przykładowo raport kampanii może zawierać liczbę kliknięć, koszt i liczbę zapytań, ale nie sprzedaż. Poprawna analiza nie powinna samodzielnie dopisywać przychodu, by obliczyć zwrot z inwestycji. Lepiej otrzymać jasno opisane ograniczenie niż kompletny wykres z wymyśloną wartością.
Po skróceniu raportu do prezentacji ponownie sprawdź sens zdań. „Wzrosła liczba zapytań” nie oznacza „wzrosła liczba klientów”. „Możliwa przyczyna” nie powinna zamieniać się na slajdzie w pewne wyjaśnienie. Odbiorca widzi zwykle gotowy plik, a nie całą historię rozmowy, w której zastrzeżenie mogło być poprawnie zapisane.
O warstwie aplikacji pisaliśmy osobno w artykule Claude Docs i Slides: dokumenty i prezentacje w rozmowie. Nowy model i funkcje edytora to osobne elementy, więc warto oceniać je oddzielnie.
Computer use: wynik zadania i granice uprawnień
Gdy AI obsługuje interfejs, poprawne kliknięcie jest dopiero częścią pracy. Trzeba jeszcze upewnić się, że zmiana trafiła do właściwego rekordu, została zapisana i nie naruszyła innych danych. Dlatego próbę warto zaczynać w środowisku testowym, na fikcyjnych danych i z jasno określonym zakresem.
Przykładowe zadanie: przygotuj szkic wpisu w panelu, wybierz wskazaną kategorię, uzupełnij opis i zatrzymaj się przed publikacją. Oceniaj zgodność pól, reakcję na brak informacji oraz to, czy agent respektuje moment wymagający Twojej decyzji. Ten scenariusz daje więcej użytecznej informacji niż samo nagranie szybko poruszającego się kursora.
Nie nadawaj na potrzeby demonstracji dostępu do całej poczty lub wszystkich dokumentów klienta. Ustal dozwolone miejsce pracy, operacje i sposób cofnięcia zmian. Nawet udana próba nie jest powodem, by od razu automatyzować płatności, usuwanie plików czy wysyłkę wiadomości bez kontroli.
Czy benchmark kodowania mówi coś o grafice i montażu?
Na podstawie pokazanych liczb nie można uznać Opusa 5.5 za najlepszego w tworzeniu modeli 3D, odtwarzaniu architektury czy montażu wideo. W takich projektach liczą się dodatkowe umiejętności: interpretacja referencji, praca w konkretnym programie, ocena proporcji i kontrola eksportu.
Jeśli chcesz porównać modele przy animacji, zadaj obu ten sam krótki ruch kamery, identyczną scenę i wymagany format pliku. Obejrzyj nie tylko kadr początkowy, lecz cały przebieg ruchu. W montażu sprawdź synchronizację, czytelność napisów, wymowę nazw i długość pauz. Kod, który uruchamia render, nie gwarantuje dobrego filmu.
Podobnie przy odtwarzaniu budynku: oceniaj zgodność z dostarczonym planem, a niewidoczne fragmenty traktuj jako interpretację. Model nie zastąpi brakującej dokumentacji samą pewnością odpowiedzi. Nasze projekty i demonstracje zbieramy w dziale projektów MAC LEE NEWS.
Gdzie jest dostępny Opus 5.5?
Ogłoszenie wymienia Claude Platform oraz AWS, Google Cloud i Microsoft Azure. Identyfikator API to claude-opus-5-5. Przed wdrożeniem sprawdź dostęp i warunki u wybranego dostawcy. Źródło: sekcja dostępności Anthropic.
Nie wybieraj sposobu dostępu wyłącznie według tabeli cen. Zespół pracujący w czacie ma inne potrzeby niż aplikacja wykonująca setki podobnych zadań. W drugim przypadku potrzebne są również limity kosztów, obsługa błędów i zapis wyników. Przy dokumentach firmowych dochodzą zasady dostępu do danych i wymagania organizacji.
Jak sprawdzić, czy warto zmienić model?
Nasza propozycja: wybierz trzy zadania, które rzeczywiście wracają w Twojej pracy. Niech każde ma materiał wejściowy, warunki zakończenia i osobę sprawdzającą rezultat. Użyj kopii danych, żeby wyniki drugiej próby nie korzystały nieświadomie z poprawek pierwszej.
- Ustal ten sam punkt startu. Ta sama wersja plików, instrukcja i dostęp do narzędzi.
- Zapisz ustawienia. Nazwa modelu, poziom rozumowania, środowisko i data próby.
- Oceń końcowy materiał. Sprawdź błędy według listy przygotowanej przed uruchomieniem, nie według tego, co wygląda efektownie.
- Policz poprawki. Zanotuj interwencje, czas kontroli i rzeczywiste zużycie. Odróżnij pracę agenta od czasu oczekiwania na człowieka.
- Powtórz trudniejszy przypadek. Pojedynczy dobry lub zły wynik jest zbyt słabą podstawą do zmiany całego procesu.
Nie musisz od razu wybierać jednego modelu do wszystkiego. Jeżeli różne zadania mają różnych zwycięzców, można przypisać narzędzia do konkretnych etapów. Warunkiem jest czytelne przekazywanie plików i kryteriów, żeby oszczędność nie zniknęła przy ręcznym przenoszeniu kontekstu.
Przy ocenie opłacalności pomoże nasz poradnik jak liczyć ROI AI w firmie. Jeśli potrzebujesz uporządkować taki proces dla swojej strony lub marketingu, zobacz Market Vision AI i zacznij od jednego, mierzalnego problemu.
Najczęstsze pytania
Czy Opus 5.5 jest lepszy od GPT-6 Astra?
Nie ma jednego rozstrzygnięcia dla wszystkich zastosowań. Pokazane rankingi mają różnych liderów i niejednakowe warunki pomiaru. Do decyzji o własnej pracy potrzebujesz zadania z porównywalnym punktem startu i kontrolą końcowego wyniku.
Czy niższy koszt oznacza tańszy abonament?
Nie należy tego zakładać. Koszt przetwarzania w API, koszt gotowego zadania i cena miesięcznego planu są odrębnymi rzeczami. Sprawdź zasady rozliczenia właściwe dla swojego sposobu korzystania.
Czy to jest nasz własny test Opusa 5.5?
Nie. Artykuł i rolka objaśniają premierę oraz dane producenta. Opisane przez nas scenariusze służą do zaplanowania własnego porównania; nie są wynikami takich prób.
Co sprawdzić jako pierwsze?
Wybierz jedno powtarzalne zadanie, przy którym potrafisz wskazać błędny i poprawny rezultat. Najpierw porównaj jakość, potem koszt zaakceptowanego wyniku. Zachowaj pliki i ustawienia, aby móc powtórzyć ocenę po kolejnej aktualizacji.
Materiały źródłowe i dalsza lektura
- Anthropic: premiera Claude Opus 5.5, tabele benchmarków i warunki pomiaru — 22 września 2026.
- Claude: What a task costs on Opus 5.5 — wyjaśnienie rozliczania pracy i cen tokenów.
- Claude Help Center: release notes — potwierdzenie daty premiery.
Źródła sprawdzone 23 września 2026. Ceny i dostępność mogą się później zmienić. Wnioski oraz propozycje zastosowań oznaczamy jako komentarz MAC LEE DESIGNS, a nie dodatkowe deklaracje Anthropic.
Obejrzyj na YouTube
 Obejrzyj na YouTube
Film otworzy się na YouTube w nowej karcie. Strona wczytuje tylko miniaturę, bez odtwarzacza i pliku wideo.
Źródła i metodologia
Analiza oficjalnego ogłoszenia Anthropic, dokumentacji wydania i wyjaśnienia kosztów, sprawdzonych 23 września 2026. Nie przeprowadziliśmy własnego porównania Opusa 5.5 z Astrą. Wyniki przypisujemy ich autorom; zastosowania, przykłady obliczeń i procedura oceny są komentarzem redakcji. Rolka omawia niezbędne fragmenty oficjalnej prezentacji z oznaczeniem źródła. Grafika artykułu jest naszym opracowaniem danych, nie zdjęciem produktu ani zrzutem aplikacji.
Weryfikacja źródeł: 23 września 2026. Masz pytanie lub zauważyłeś błąd? Napisz do redakcji.